2024. 7. 8. 11:43ㆍ개발
DFS 알고리즘
Depth First Search의 약자로 깊이 우선 탐색 알고리즘을 의미
특징
스택 또는 재귀함수 형태로 구현
한 방향으로 탐색하다가 더 이상 갈 수 없게 되면, 가까운 분기점으로 돌아와(백트래킹) 다른 방향으로 탐색 진행

위 그래프를 예로 들면 1번 노드부터 탐색을 시작하여 2번 노드를 거친 뒤 3번 노드까지 탐색을 진행한다.
3번 노드에서는 더 이상 탐색할 노드가 없으므로 2번 노드로 백트래킹하여 분기점인 4번 노드로 다시 탐색을 이어나가는 방식이다.
이런식으로 끝까지 진행하게 되면 번호 순서대로 그래프를 탐색하게 된다.
코드스테이츠에서 이해하기 쉽게 표현한 이미지가 있어 가져왔다.
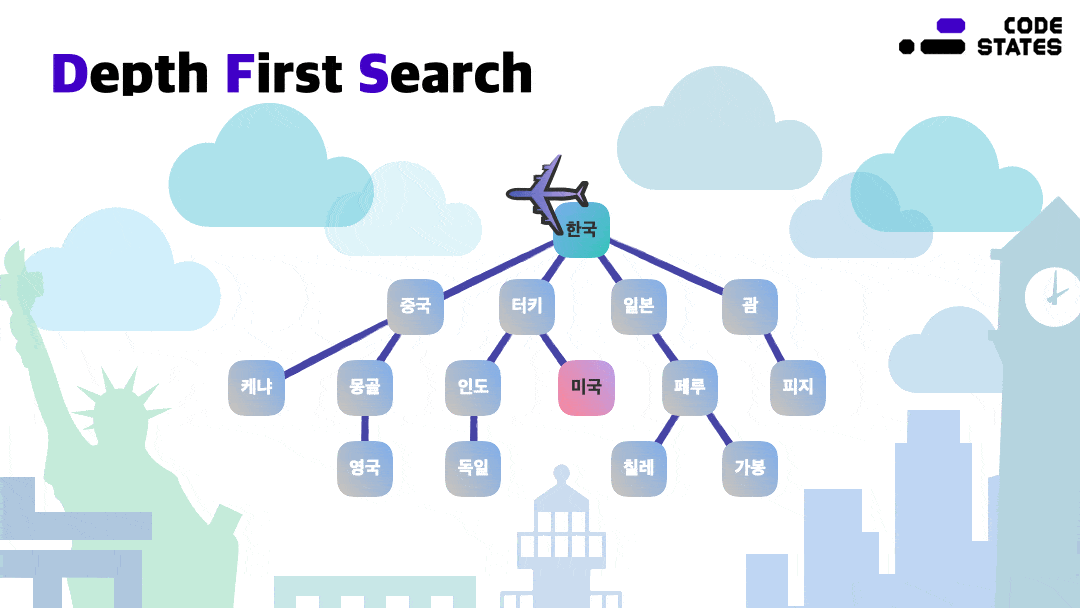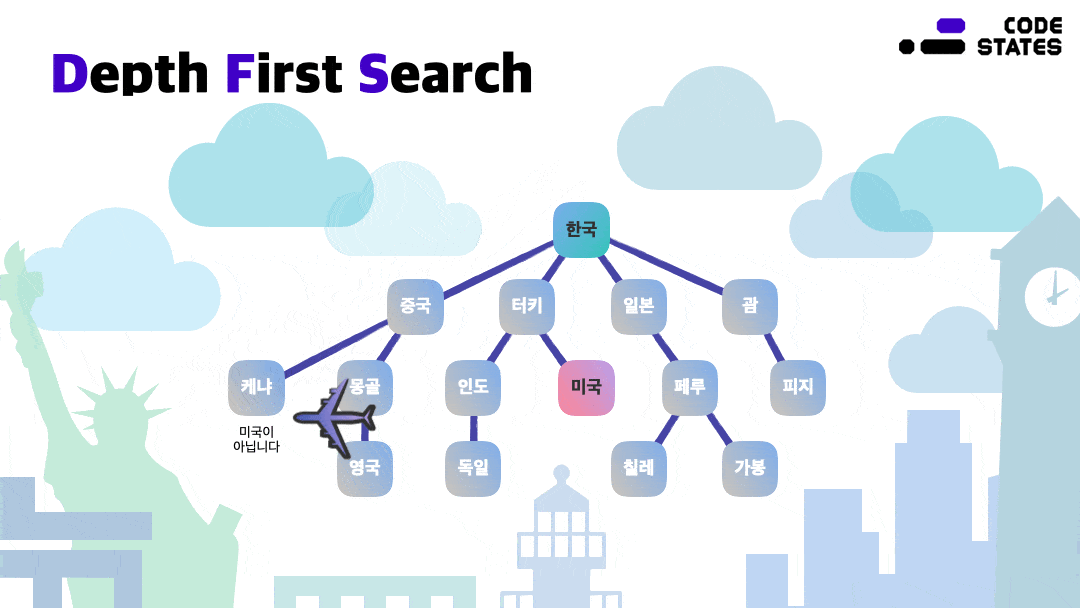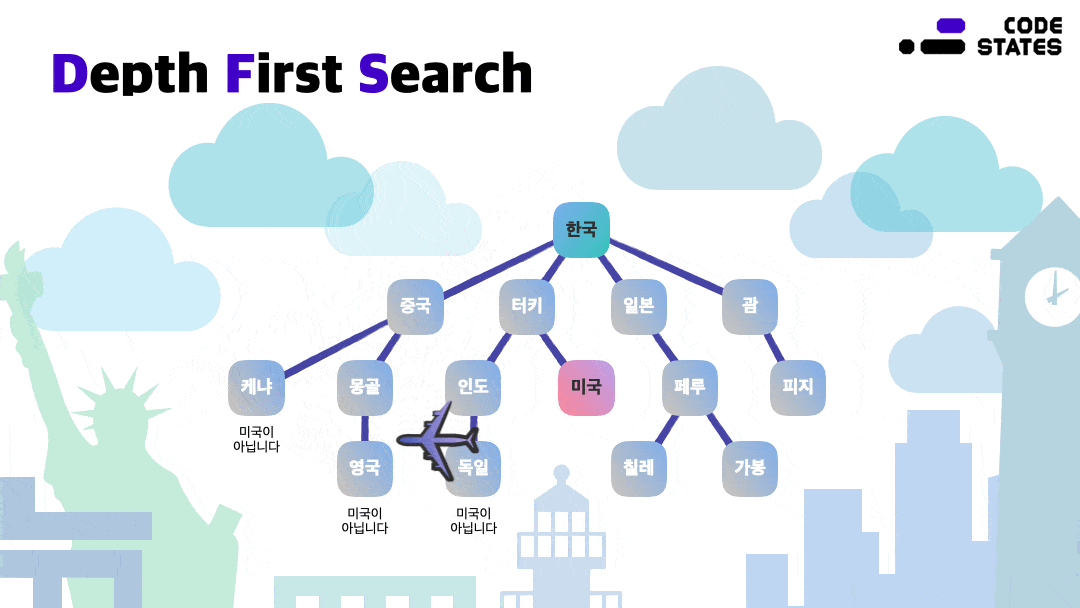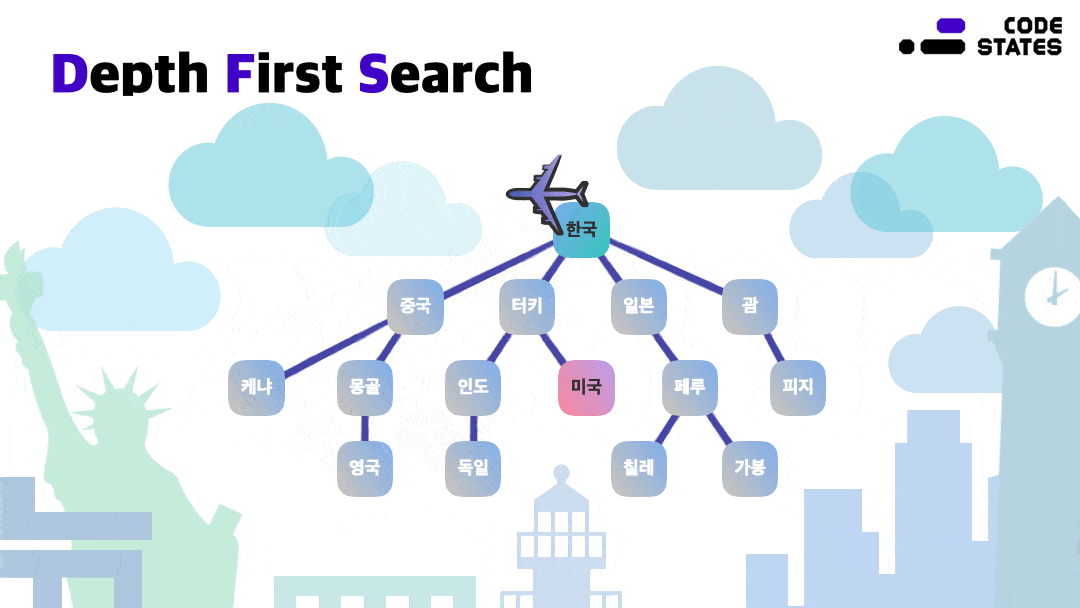
물론 기준이나 구현 방법에 따라 탐색 순서는 바뀔 수 있다. 아래 예제 코드에서 다시 살펴보자.
예제
그래프를 코드로 표현할 때 대표적으로 2가지 방식이 있다.
1. 인접 리스트
노드에 연결된 다른 노드를 list로 표현
모든 노드(N)과 연결된 간선(E)의 개수만큼 연산이 발생하므로 시간복잡도 O(N+E)
// list 초기화(0번은 사용 안함)
LinkedList<Integer>[] list = new LinkedList[10];
for (int i = 0; i < list.length; i++) {
    list[i] = new LinkedList<>();
}

// 1번 노드와 인접한 노드
list[1].add(2);
list[1].add(4);
list[1].add(5);

// 2번 노드와 인접한 노드
list[2].add(1);
list[2].add(3);
list[2].add(4);

// 3번 노드와 인접한 노드
list[3].add(2);
.
.
.
2. 인접 행렬
노드 연결 관계를 2차원 행렬로 표현하므로 노드 수의 제곱(N^2)만큼 메모리 필요
모든 노드(N)를 방문하기 때문에 시간복잡도는 O(N^2)
int[][] array = {
    {0, 0, 0, 0, 0, 0, 0, 0, 0, 0}, // 0번 노드는 사용 안함
    {0, 0, 1, 0, 1, 1, 0, 0, 0, 0}, // 1번 노드와 인접한 노드 1로 표시
    {0, 1, 0, 1, 1, 0, 0, 0, 0, 0}, // 2번 노드와 인접한 노드 1로 표시
    {0, 0, 1, 0, 0, 0, 0, 0, 0, 0}, // 3번 노드와 인접한 노드 1로 표시
    {0, 1, 1, 0, 0, 0, 0, 0, 0, 0}, // 4번 노드와 인접한 노드 1로 표시
    {0, 1, 0, 0, 0, 0, 1, 0, 0, 0}, // 5번 노드와 인접한 노드 1로 표시
    {0, 0, 0, 0, 0, 1, 0, 1, 1, 0}, // 6번 노드와 인접한 노드 1로 표시
    {0, 0, 0, 0, 0, 0, 1, 0, 0, 0}, // 7번 노드와 인접한 노드 1로 표시
    {0, 0, 0, 0, 0, 0, 1, 0, 0, 1}, // 8번 노드와 인접한 노드 1로 표시
    {0, 0, 0, 0, 0, 0, 0, 0, 1, 0} // 9번 노드와 인접한 노드 1로 표시
};
예제 코드는 그래프를 인접 리스트 형태의 2차원 배열로 표현하였고 재귀 함수와 스택 2가지로 나누어 구현하였다.
- 재귀 함수
@Slf4j
class DfsTest {

    // 그래프
    static int[][] graph = {
            {}, // 0번 노드
            { 2, 4, 5 }, // 1번 노드와 인접한 노드
            { 1, 3, 4 }, // 2번 노드와 인접한 노드
            { 2 }, // 3번 노드와 인접한 노드
            { 1, 2 }, // 4번 노드와 인접한 노드
            { 1, 6 }, // 5번 노드와 인접한 노드
            { 5, 7, 8 }, // 6번 노드와 인접한 노드
            { 6 }, // 7번 노드와 인접한 노드
            { 6, 9 }, // 8번 노드와 인접한 노드
            { 8 } // 9번 노드와 인접한 노드
    };

    // n번 노드 방문 여부
    static boolean[] isVisit = new boolean[graph.length];

    @Test
    public void test() {
        // 1번 노드부터 탐색
        dfs(1);
    }

    private void dfs(int index) {
        log.info("{}번 노드 탐색 ", index);

        // 방문 처리
        isVisit[index] = true;

        // 현재 노드와 인접한 노드 찾기
        for (int i = 0; i < graph[index].length; i++) {
            int node = graph[index][i];

            // 인접한 노드를 방문하지 않았으면 이어서 탐색
            if (!isVisit[node]) {
                dfs(node);
            }
        }
    }
}
탐색 순서 : 1번 노드 -> 2번 노드 -> 3번 노드 -> 4번 노드 -> 5번 노드 -> 6번 노드 -> 7번 노드 -> 8번 노드 -> 9번 노드
- 스택
@Slf4j
class DfsTest {

    // 그래프
    static int[][] graph = {
            {}, // 0번 노드
            { 2, 4, 5 }, // 1번 노드와 인접한 노드
            { 1, 3, 4 }, // 2번 노드와 인접한 노드
            { 2 }, // 3번 노드와 인접한 노드
            { 1, 2 }, // 4번 노드와 인접한 노드
            { 1, 6 }, // 5번 노드와 인접한 노드
            { 5, 7, 8 }, // 6번 노드와 인접한 노드
            { 6 }, // 7번 노드와 인접한 노드
            { 6, 9 }, // 8번 노드와 인접한 노드
            { 8 } // 9번 노드와 인접한 노드
    };

    // n번 노드 방문 여부
    static boolean[] isVisit = new boolean[graph.length];

    // 스택
    static Stack<Integer> stack = new Stack<>();

    @Test
    public void test() {
        stack.push(1);

        while (!stack.isEmpty()) {
            int node = stack.pop();

            if (isVisit[node]) {
                continue;
            }

            log.info("{}번 노드 탐색 ", node);

            isVisit[node] = true;

            for (int i = 0; i < graph[node].length; i++) {
                int linkedNode = graph[node][i];

                if (!isVisit[linkedNode]) {
                    stack.push(linkedNode);
                }
            }
        }
    }
}
탐색 순서 : 1번 노드 -> 5번 노드 -> 6번 노드 -> 8번 노드 -> 9번 노드 -> 7번 노드 -> 4번 노드 -> 2번 노드 -> 3번 노드
두 예제를 비교해보면 탐색 순서가 다르게 나온다.
재귀 함수가 처음으로 발견한 노드의 인접 노드부터 탐색하는데 반해,
스택은 후입선출(Last-In-First-Out) 특성으로 마지막 노드의 인접 노드부터 탐색하기 때문이다.
이는 잘못된 것이 아니라 기준 및 구현 방법에 따라 바뀔 수 있는 것으로, 한 방향으로 계속 탐색한다는 점에서 DFS(깊이 우선 탐색)라고 할 수 있다.
참고
[Algorithm] DFS (Depth-first Search)를 Java로 구현해보자!
안녕하세요 Coding-Knowjam입니다. 오늘은 그래프와 트리를 탐색할 때 사용되는 DFS알고리즘에 대해서 알아보겠습니다. 1. DFS (Depth-first Search)란? DFS는 번역하면 깊이 우선 탐색이라고 합니다. 이름에
codingnojam.tistory.com
[Algorithm/Java] DFS(깊이 우선 탐색)
DFS(Depth-First Search) : 깊이 우선 탐색 그래프 완전 탐색 : 모든 노드를 방문하고자 할때, 이 방법을 선택한다. 그래프의 시작 노드에서 출발하여 탐색할 한 쪽 분기를 정해서 최대깊이까지 탐색을
innovation123.tistory.com
[알고리즘/Java]그래프와 DFS, BFS 탐색 알고리즘
탐색 알고리즘은 입력으로 주어진 그래프를 탐색하고, 그 "구조"를 파악하는 알고리즘이다. 수많은 흥미로운 문제가 그래프로 표현 가능하기 때문에, 그래프를 탐색하고 구조를 파악하는 건 중
belklog.tistory.com
'개발' 카테고리의 다른 글
| Java에서 외부 API 발송시 PKIX path building failed 예외 (0) | 2025.01.15 |
|---|